AI 搜尋情緒監控
AI 提到你,是誇你還是扣你分?
每一則 AI 回答都會判斷情緒方向,並把用來判斷的原文片段一起留下。你看到的不是一個分數,而是「這句話說了什麼、屬於正面還是負面」。
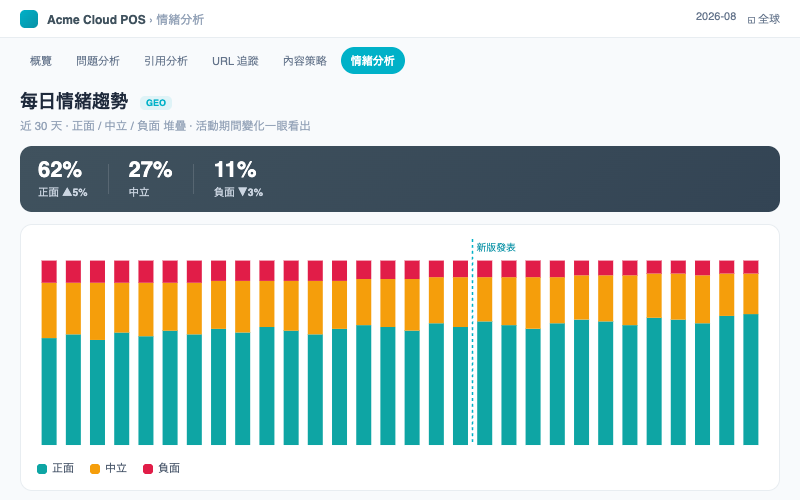
- 主品牌與所有競品的正 / 中 / 負佔比並列
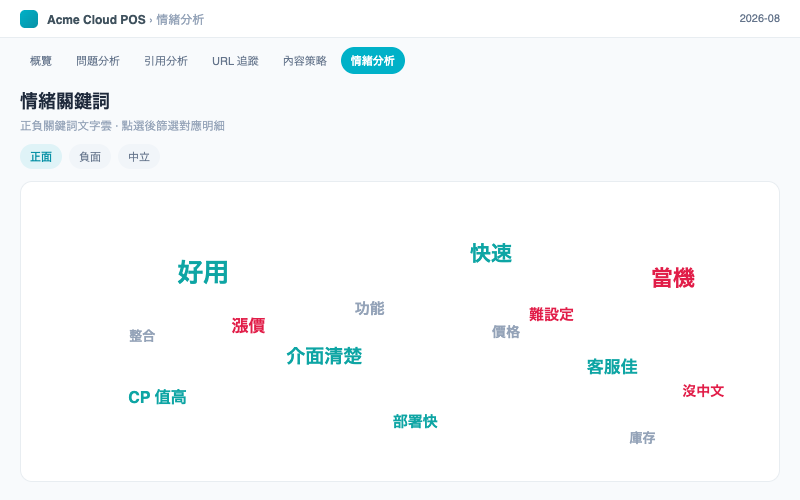
- 正負關鍵詞文字雲,點一下即時篩選明細
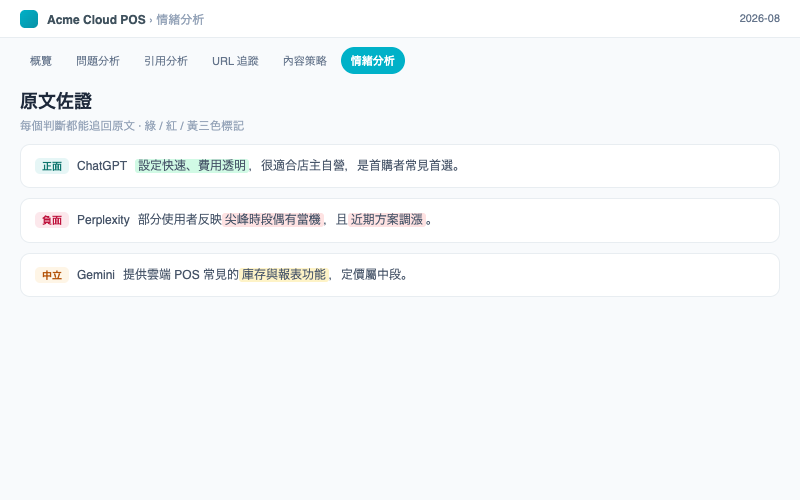
- 原文佐證標色:正面綠底、負面紅底、品牌名黃底
負面敘述通常不是一夜之間出現的
AI 的回答會左右購買決策,但沒有人會通知你它開始講你的壞話。
- 提及率上升,實際上被講的內容卻越來越不利,只看次數看不出來。
- 客戶或主管問「AI 為什麼這樣說我們」,手上沒有原文可以佐證。
- 負面說法散在數百則回答裡,人工翻不完,也不知道該先處理哪一則。
情緒監控怎麼運作
分數怎麼算
分數 =(正面 − 負面)÷(正面 + 負面),範圍 −1 ~ +1。中立與未提及不列入分母——品牌沒被提到不等於評價中立,若計入會把分數往 0 稀釋。頁面頂端同時顯示平均分與已分析回應數。
全自動,不需手動觸發
每次 GEO 同步後會自動分析新回答,畫面上沒有「開始分析」按鈕;分析進行中會在標題列顯示進度。
品牌情緒總表
主品牌與所有競品的正 / 中 / 負佔比與平均分並列,一張表看完相對位置。每個品牌另有各自的平台情緒條。
關鍵詞文字雲
正面關鍵詞(綠)與負面關鍵詞(紅)分開呈現。點任一關鍵字會自動帶入品牌 + 情緒 label + 搜尋詞,下方明細只顯示對應項目,再點一次取消。
原文佐證
展開任一明細會顯示「品牌 · keyword ↔ AI 原文片段」一一對應清單,並在 AI 回答內文中標色:正面綠底、負面紅底、品牌名黃底。
明細篩選與排序
可依日期、平台、分類、Prompt、品牌、情緒 label 與關鍵字搜尋;排序支援日期新→舊、負面優先、正面優先,用來快速掃出最需要處理的內容。每頁 50 筆。
為什麼這裡的負面分數可以信
LLM 有時會對「根本沒出現在原文的品牌」硬扣負面標籤。我們用三層防禦攔截。
三層幻覺攔截
一、原文品牌校驗:目標品牌名(含所有別名)未出現在 AI 回答原文時,一律強制歸為未提及。二、禁止詞名單:伺服器端過濾 20 個以上常見幻覺詞(推薦不足、認可度低、存在感不足、知名度低……),前端詞雲與明細再套一次相同過濾。三、原文片段校驗:LLM 給的每個判斷都必須真的是原文的一段文字才會保留。
新增或刪除競品時自動補齊
新增競品後,系統自動針對缺這個競品分析的舊回答跑增量補分析,只分析新競品、不動既有結果,背景執行通常 1–5 分鐘完成;期間該競品會標示「資料分析中」。刪除競品時會一併清除其情緒資料。
畫面預覽
你可能想問
Q情緒詞是誰決定的?
由模型從 AI 回答中萃取形容詞,例如「合身度待注意」。寫入前會驗證該原文片段確實出現在回答裡,避免幻覺。
QAI 會不會亂給我負面標籤?
會,這也是我們做三層攔截的原因:原文沒有出現品牌名一律歸為未提及、伺服器端過濾常見幻覺詞、每個判斷都要對得上原文片段。
Q新增競品後,過去的資料要重跑嗎?
不用。系統會自動針對缺該競品的舊回答做增量補分析,背景執行通常 1–5 分鐘完成。
Q為什麼未提及不算進分數?
因為沒被提到不代表評價中立。把未提及計入分母會把分數往 0 稀釋,反而看不出真實情緒。
告訴我們你的需求
填寫表單後,我們的業務團隊會盡快與你聯繫,安排產品導覽。