AI検索のセンチメント監視
AIがあなたに触れるとき、褒めているのか、減点しているのか?
すべてのAI回答についてセンチメントの方向を判定し、その判断に使った原文の断片も一緒に残します。見えるのは単なるスコアではなく、「この一文が何を語り、ポジティブかネガティブか」です。
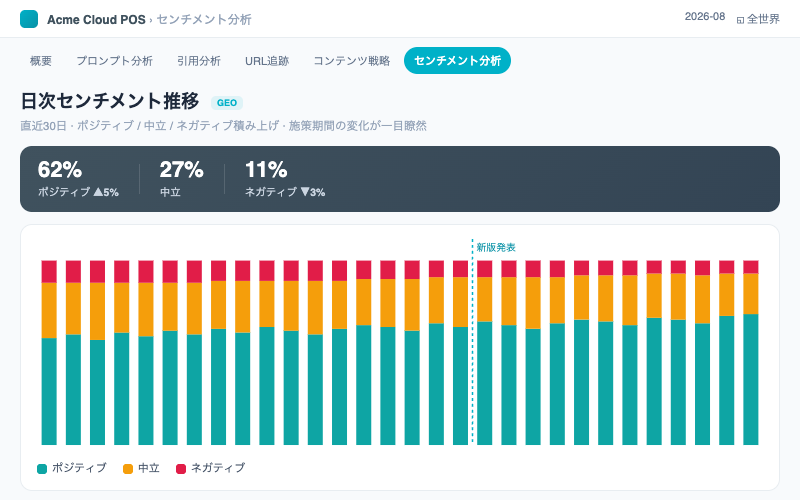
- 主要ブランドと全競合のポジ / 中立 / ネガ比率を並列表示
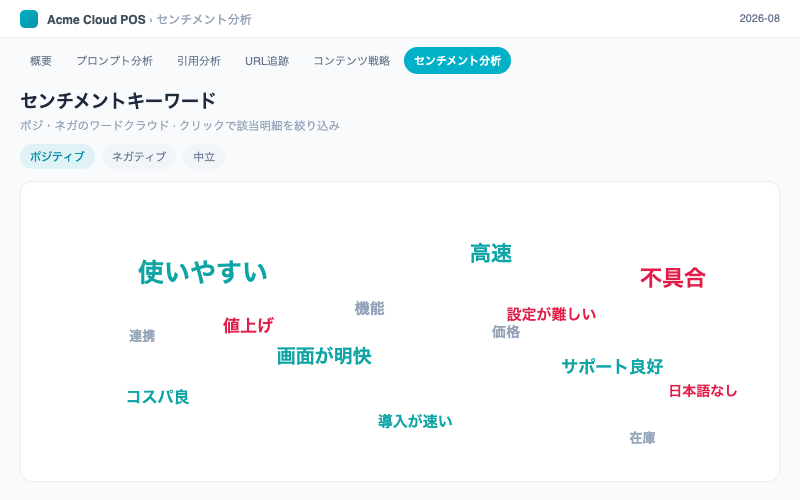
- ポジ・ネガのキーワードクラウド、クリックで明細を即絞り込み
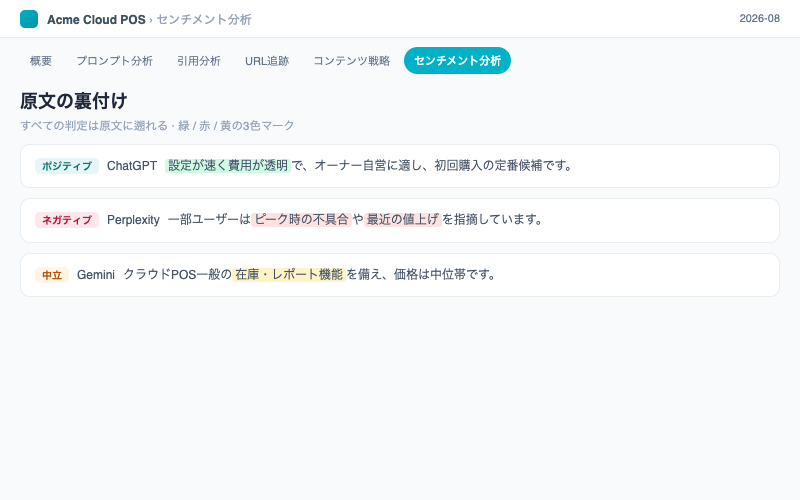
- 原文の裏付けを色分け:ポジは緑、ネガは赤、ブランド名は黄
ネガティブな語られ方は、たいてい一夜で現れるものではありません
AIの回答は購買判断を左右しますが、悪く言われ始めても誰も通知してくれません。
- 言及率は上がっているのに、実際に語られる内容はむしろ不利になっている——回数だけでは見抜けません。
- クライアントや上司に「なぜAIはうちをそう言うのか」と問われても、手元に裏付けの原文がありません。
- ネガティブな主張は数百件の回答に散らばり、人手では読み切れず、どれから対処すべきかも分かりません。
センチメント監視の仕組み
スコアの算出方法
スコア =(ポジ − ネガ)÷(ポジ + ネガ)、範囲は −1 〜 +1。中立と未言及は分母に含めません——言及されないことは中立の評価ではなく、含めればスコアが0へ薄まってしまうためです。ページ上部には平均スコアと分析済み回答数も表示されます。
全自動、手動トリガー不要
GEO同期のたびに新しい回答を自動で分析し、「分析開始」ボタンはありません。実行中はタイトル行に進捗が表示されます。
ブランドセンチメント総表
主要ブランドと全競合のポジ / 中立 / ネガ比率と平均スコアを並列表示し、相対的な位置を一表で把握できます。各ブランドにはプラットフォーム別のセンチメントバーもあります。
キーワードクラウド
ポジティブ(緑)とネガティブ(赤)のキーワードを分けて表示。任意の語をクリックすると、ブランド + センチメントラベル + 検索語が自動で入り、下の明細は該当項目のみに。もう一度クリックで解除します。
原文の裏付け
任意の明細を展開すると「ブランド · キーワード ↔ AI原文の断片」の一対一リストが表示され、AI回答本文にも色付け:ポジは緑、ネガは赤、ブランド名は黄です。
明細の絞り込みと並べ替え
日付・プラットフォーム・カテゴリ・プロンプト・ブランド・センチメントラベル・キーワード検索で絞り込み可能。並べ替えは日付の新しい順、ネガ優先、ポジ優先に対応し、対処すべき内容を素早く洗い出せます。1ページ50件。
なぜここのネガティブスコアは信頼できるのか
LLMは、原文に一切登場しないブランドにまで無理にネガティブのラベルを付けることがあります。これを三層の防御で遮断します。
三層の幻覚遮断
一、原文ブランド照合:対象ブランド名(全別名を含む)がAI回答の原文に出現しない場合は、一律「未言及」に強制します。二、禁止語リスト:サーバー側で20以上の典型的な幻覚語(推薦不足、認知度が低い、存在感が薄い、知名度が低い…)を除外し、フロント側のワードクラウドと明細でも同じ除外を再適用します。三、原文断片照合:LLMが出した各判断は、本当に原文の一節であるものだけを残します。
競合の追加・削除時に自動で補完
競合を追加すると、その競合の分析が欠けている過去の回答に対し、システムが自動で増分分析を実行します。新しい競合だけを分析し、既存の結果には触れず、通常は1〜5分でバックグラウンド完了。その間、当該競合には「データ分析中」と表示されます。競合を削除すると、そのセンチメントデータも併せて消去されます。
画面プレビュー
よくあるご質問
Qセンチメントの語は誰が決めるのですか?
モデルがAI回答から形容表現を抽出します(例:「フィット感に注意」)。保存前に、その断片が本当に回答内に現れるかを検証し、幻覚を避けます。
QAIが勝手にネガティブのラベルを付けませんか?
付くことがあります。だからこそ三層の遮断を行います:原文にブランド名がなければ未言及、サーバー側で典型的な幻覚語を除外、各判断は原文断片と一致することが条件です。
Q競合を追加した後、過去データを再実行する必要は?
不要です。その競合が欠けている過去の回答に対し、システムが自動で増分分析を行い、通常は1〜5分でバックグラウンド完了します。
Qなぜ未言及はスコアに入れないのですか?
言及されないことは中立の評価を意味しないためです。未言及を分母に含めるとスコアが0へ薄まり、かえって本当の感情が見えなくなります。
ご要望をお聞かせください
送信後、担当者よりできるだけ早くご連絡し、オンラインデモをご案内します。